Generative Modeling by Estimating Gradients of the Data Distribution
Yang Song, Stefano Ermon | NeurIPS 2019 | arXiv:1907.05600
1 Score matching
1.1 生成模型和 Score matching 动机
生成模型的目的是获取所需要生成范畴中的对象(如图片)的隐藏分布。生成的过程就是从该分布中采样。假设有从一个未知分布
中采样得到的数据集
。我们要尝试估计该分布。一个自然的假设是
其中
是某个函数,
是归一化因子。若不加其他考虑,直接处理
将会不可避免地遇到计算
的困难。因此 Score matching 的一个核心思路是转而去估计分布的 Score function,其“几何直观”的意义是指向概率密度增加的方向:
1.2 以方便计算为目的的 Score matching 目标函数变换
自然地,我们有 Score matching 的原始目标函数:
但由于我们不知道原始数据的分布,因此我们无法求得
,可以做下面的变换
1.3 降低目标函数计算成本
上式中的
计算成本还是太高。庆幸我们可以对原数据增加 Gaussian 噪声,从而将其经过一个条件分布
得到加噪声后的数据
。经计算后我们能得到更加实际的目标函数。我们可以从扰动后的数据向量
对应的损失函数开始推导:
注意此时
还可以写为
,其中
是从
中采样得到的噪声,原目标函数就变成
换句话说,score function 在这个意义下正在预测加入到训练数据中的噪声。在实际操作中,我们需要权衡
的取值,如果太小,该方法起不到明显效果;如果太大,加噪声后的分布和原分布的区别大,难以学习原分布的特征。
2 Langevin 动力学
假如我们已经训练好
,我们应该如何做"生成"这个动作呢?根据 score function 拟合概率的对数梯度
,它指向概率密度上升的方向。我们可以按照自然地想法做梯度上升,这样迭代就可以得到很有可能属于该分布的点:
但这一方法总会使得若干步后的采样结果收敛于原始分布之密度函数的若干极大值点,与生成模型的多样性目标不符。因此为解决这一问题,我们可以用 Langevin Dynamics 来采样。其与原来方法的区别在于在每一步中加入噪声,最后迭代得到的结果将会服从原始分布
:
其中
。
3 Score-based 生成模型的问题
- 一是流形假设造成的问题。我们所处世界中的高维数据往往分布在一个低维流形上。但上文中提到的对数据分布密度函数在低维流形的环绕空间
中求梯度是没有意义的。
- 二是低概率密度区域的估计问题。如果原分布是一个混合分布,且两个 “峰” 中间存在一个低概率密度的区域,模型学习时将难以获取该区域的信息,最后训练的结果在该区域的表现将会很差。
如果我们使用 Gauss 分布对原分布做扰动,则得到的新分布的支持集将会是整个环绕空间,而不是流形。另一方面,恰当强度的扰动也会使得低概率密度区域的概率密度增加,从而更容易采样到该区域中的点,为模型训练提供更多的信息。
4 方法
上文中提到,对数据做扰动时,大强度的扰动会使得训练变得简单,但扰动后的分布与原分布相差很大;小强度的扰动使得扰动后分布近似原分布,但会有诸如低概率密度区域训练点不足的问题。
文中提出一个整合两者有点的方法,即不考虑单个扰动强度
,而是考虑一个序列
其中
是一个足够小的数 (例如 0.01),
是一个足够大的数 (例如 25)。我们训练一个条件 score function
预测不同扰动强度下的噪声方向。此时目标函数变为
其中
是权重函数,常取为
,以平衡不同扰动强度下 score function 的范数。在采样时,我们就做类似模拟退火的采样动作。首先选取最高的扰动强度
然后在该噪声强度下迭代若干次,然后选取次高的扰动强度
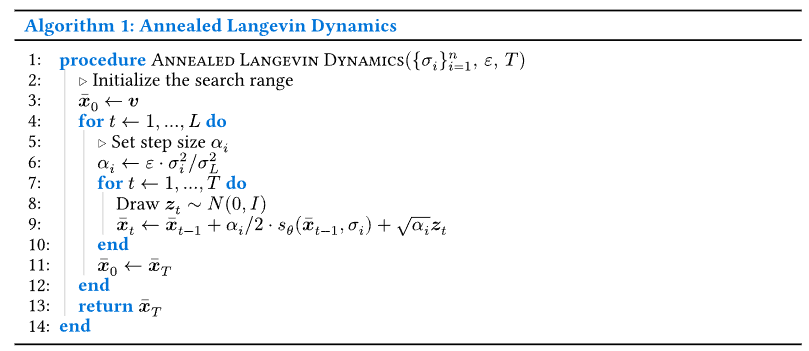
并在该噪声强度下迭代若干次,以此类推。这样就可以综合利用大扰动强度和小扰动强度的有点,从而更好的采样。在实际实验中,作者提出的方法在 CIFAR-10 数据集上取得了不错的效果。整个过程如下面的算法所示。
参考资料
5 附录
在推导 Score matching 中的优化目标变换时,在
这一步遇到了问题。讲解视频中常常将
考虑为一维向量,从而规避了这里的推导。一维版本推导中使用到分部积分公式,我推测多维版本也使用了分部积分公式。我参考 链接1 中的内容将其中的缺失步骤补齐,并填补先前没有学好的散度相关知识。
对于函数
,其对应的微分算子可以写成
,这与
的梯度相容,因为
。散度是该微分算子和向量场
的内积:
对于标量值函数
,可以证明有下面的性质
通过该运算法则,就有向量场的分部积分公式。设
是
中的一个有界开集,其边界
分段光滑,则有高斯散度定理:
将前面推导的散度乘法法则
代入上式左边,得到:
移项后即得到高维空间中的分部积分公式:
或者等价地:
在 Score matching 的推导中,由于积分区域是全空间
,并假设概率密度函数
及其梯度在无穷远处足够快地衰减为零(即满足边界条件),因此应用上述分部积分公式时,边界项积分为零。
参考资料
