Denoising Diffusion Probabilistic Models

Jonathan Ho, Ajay Jain and Pieter Abbeel | https://arxiv.org/abs/2006.11239

0 综观

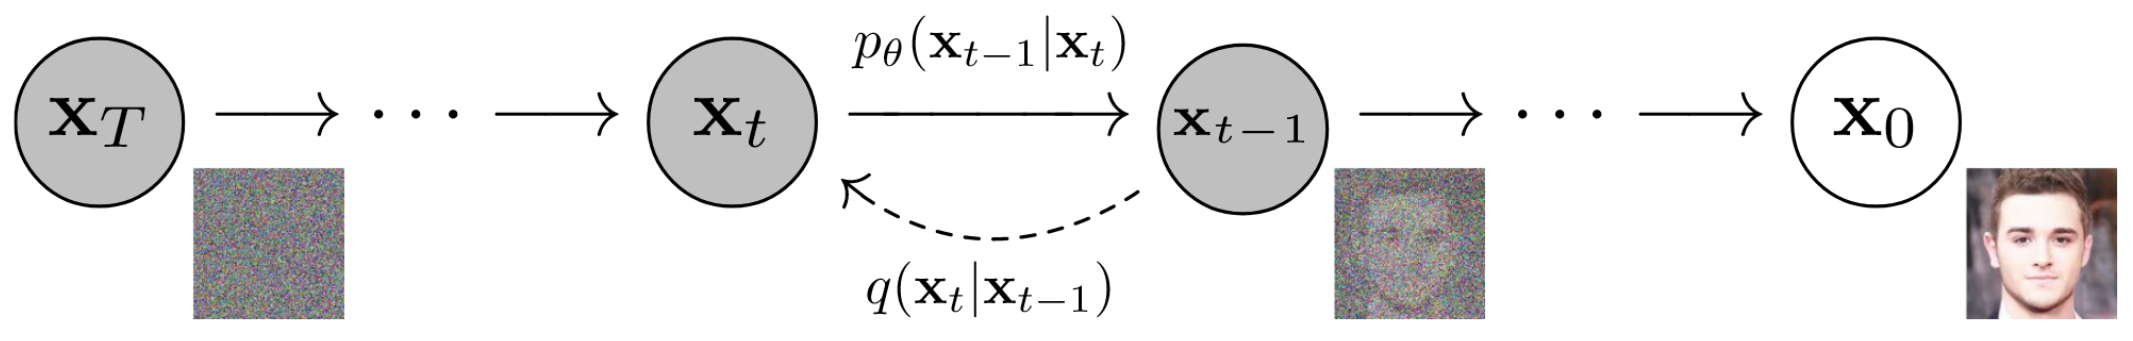
不同于 VAE 等等的一个隐变量空间的生成模型,DDPM 尝试用多步编码/解码,或是加噪/去噪方式生成数据。它的每一步可以视为是一个去噪自编码器(Denoising Autoencoder),而其采样(生成)过程通过与加噪过程的 Markov 链"共用",并通过预测加噪过程中的随机噪声实现加噪过程的 "反转",并添上 Langevin 动力学的随机噪声实现对分布的采样。与正常的 Langevin 动力学不同的是,从第 t 步到 t−1 步,我们认为其在尝试适配一个分布 p(xt−1|xt) 过程中,只做了一次 Langevin 动力学的迭代。

1 加噪过程的建模

首先对于加噪过程,我们有一列噪声强度 {βt}t=0T ,然后按照 q(xt|xt−1)∼N(xt−1|βtI) 来进行:

xt=1−βtxt−1+βtϵt,ϵt∼N(0,I)=1−βt[1−βt−1xt−2+βt−1ϵt−1]+βtϵt,ϵt−1∼N(0,I)=(1−βt)(1−βt−1)xt−2+(1−βt)βt−1ϵt−1+βtϵt=(1−βt)(1−βt−1)xt−2+(1−βt)βt−1−(1−βt)+1ϵ~t,ϵ~t∼N(0,I)=(1−βt)(1−βt−1)xt−2+1−(1−βt)(1−βt−1)ϵ~t⋮=∏s=1t(1−βs)x0+1−∏s=1t(1−βs)ϵ~t=α¯tx0+1−α¯tϵ~t

这给出了加噪过程中每一步得到的 xt 更加便捷的表示,对后续的推导有帮助。

2 优化目标

由于我们的目标是从随机噪声 x0 生成图像,即 xT ,因此需要最大化的项是 Ept[−log⁡pt(x0)] 。因此我们需要继续用变分推断的技巧,逐步将其转化为可以计算得到的项。首先我们有下面的上界

Ept[−log⁡pt(x0)]=Ept[−log⁡pt(x0)∫q(x1:T|x0)dx1:T]=Ept[−∫q(x1:T|x0)log⁡pt(x0)dx1:T]=−Ept(x0),q(x1:T|x0)[log⁡pt(x0)pt(x1:T|x0)pt(x1:T|x0)]=−Ept(x0),q(x1:T|x0)[log⁡pt(x0:T)q(x1:T|x0)pt(x1:T|x0)q(x1:T|x0)]=−Ept(x0),q(x1:T|x0)[log⁡pt(x0:T)q(x1:T|x0)]−Ept(x0),q(x1:T|x0)[log⁡q(x1:T|x0)pt(x1:T|x0)]=−Ept(x0),q(x1:T|x0)[log⁡pt(x0:T)q(x1:T|x0)]−Ept(x0)[DKL[q(x1:T|x0)∥pt(x1:T|x0)]]⏟>0<Eq[log⁡q(x1:T|x0)pt(x0:T)]=:L

上式中的 x1:T 不好处理,我们可以将打包的变量拆开,最后可以将其写成若干项 KL 散度之和,其中两项对应着 Markov 链头和尾,剩余的对应加噪过程的中间状态。

L=Eq[log⁡q(x1:T|x0)pt(x0:T)]=Eq[log⁡q(xT|x0)∏t=2Tq(xt−1|xt,x0)pt(xT)∏t=1Tpt(xt−1|xt)]=Eq[log⁡q(xT|x0)p(xT)+∑t=2Tq(xt−1|xt,x0)pt(xt−1|xt)+log⁡1pt(x0|x1)]=Eq[DKL[q(xT|x0)∥p(xT)]+∑t=2TDKL[q(xt−1|xt,x0)∥pt(xt−1|xt)]−log⁡pt(x0|x1)]=Eq[LT+∑t=2TLt−1−L0].

显然,得到的结果符合我们的预期,我们需要训练一个带参分布 pθ(xt−1|xt,x0) ,并让其与 q(xt−1|xt,x0) 对齐。后者是一个 Gauss 分布,使用 Bayes 公式不难得到它的分布参数

q(xt−1|xt,x0)=q(xt|xt−1,x0)q(xt−1|x0)q(xt|x0)=q(xt|xt−1)q(xt−1|x0)q(xt|x0)∝exp⁡{−12[∥xt−αtxt−1∥2βt+∥xt−1−α¯t−1x0∥21−α¯t−1−∥xt−α¯tx0∥21−α¯t]}=exp⁡{−12[∥xt∥2−αt⟨xt,xt−1⟩+αt∥xt−1∥2βt+∥xt−1∥2−α¯t−1⟨xt−1,x0⟩+α¯t−1∥x0∥21−α¯t−1−∥xt∥2−α¯t⟨xt,x0⟩+α¯t∥x0∥21−α¯t]}=exp⁡{−12[(αtβt+11−α¯t−1)∥xt−1∥2−⟨αtβtxt+α¯t−11−α¯t−1x0,xt−1⟩+const]}∝exp⁡{∥xt−1−μ~t∥22β~t}

其中均值 μ~t 和方差 β~t 为

β~t=1/(αtβt+11−α¯t−1)=(1−α¯t−1)(1−α¯t)⋅βtμ~t=αtβtxt+α¯t−11−α¯t−1x0αtβt+11−α¯t−1=(αtβtxt+α¯t−11−α¯t−1x0)(1−α¯t−1)(1−α¯t)⋅βt=αt(1−α¯t−1)(1−α¯t)xt+α¯t−1βt(1−α¯t)x0

由于需要匹配一个 Gauss 分布,带参分布 q(xt−1|xt,x0) 也需要是一个 Gauss 分布 N(μθ,t,Σθ,t) ,不过在此我们将协方差矩阵简化为对角,即 μθ,t=βθ,tI 。此时我们可以求中间过程的 KL 散度,由于其参数是两个 Gauss 分布,我们有现成的结论:

Lt−1=DKL[q(xt−1|xt,x0)∥pt(xt−1|xt)]=12[log⁡|β~tI||βθ,tI|−n+tr(β~t−1Iβθ,tI)+(μ~t−μθ,t)⊤βθ,t−1I(μ~t−μθ,t)]=12σt[∥μ~t−μθ,t∥2]+const,令βθ,t为只与时间相关的σt=12σt[‖αt(1−α¯t−1)(1−α¯t)xt+α¯t−1βt(1−α¯t)⋅1α¯t(xt−1−α¯tϵ)−μθ,t‖2]+const=12σt[‖(αt(1−α¯t−1)+βt)(1−α¯t)αtxt+βtαt1−α¯tϵ−μθ,t‖2]+const=12σt[‖(1−α¯t)(1−α¯t)αtxt−βtαt1−α¯tϵ−μθ,t‖2]+const,αt=1−βt,α¯t=∏s=0tαt=12σt[‖1αt[xt−(1−αt)1−α¯tϵ]−μθ,t‖2]+const

进一步地,我们可以将预测均值 μθ,t 建模为与 μ~t 相同的形式,即

μθ(xt,t)=1αt[xt−(1−αt)1−α¯tϵθ(xt,t)]

因此 Lt−1 还可以进一步简化

Lt−1=12σt[‖1αt[xt−(1−αt)1−α¯tϵ]−μθ,t‖2]+const=12σt[‖1αt[xt−(1−αt)1−α¯tϵ]−1αt[xt−(1−αt)1−α¯tϵθ(xt,t)]‖2]+const=(1−αt)22σtαt(1−α¯t)‖ϵ−ϵθ(xt,t)‖2+const

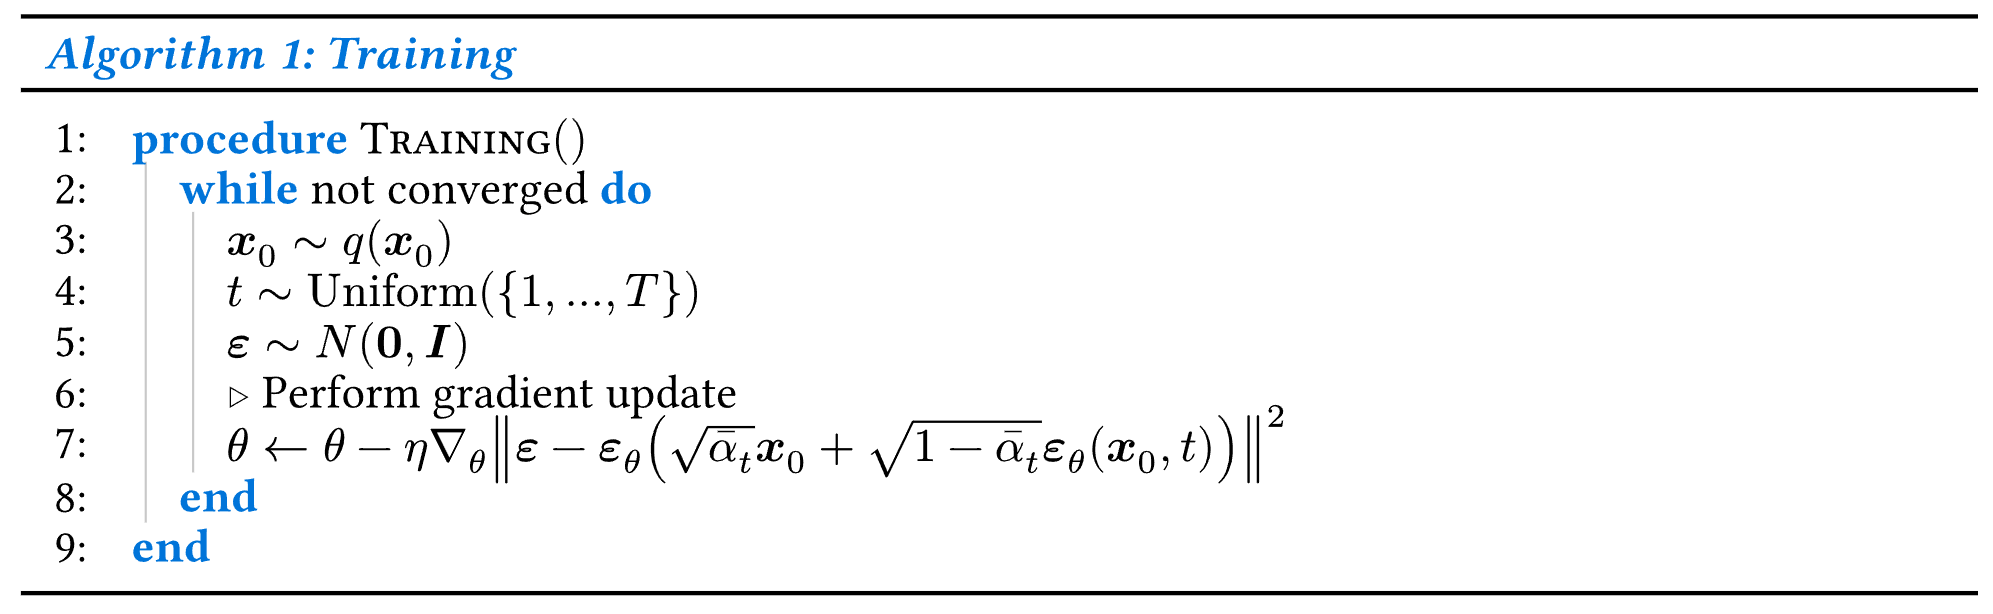
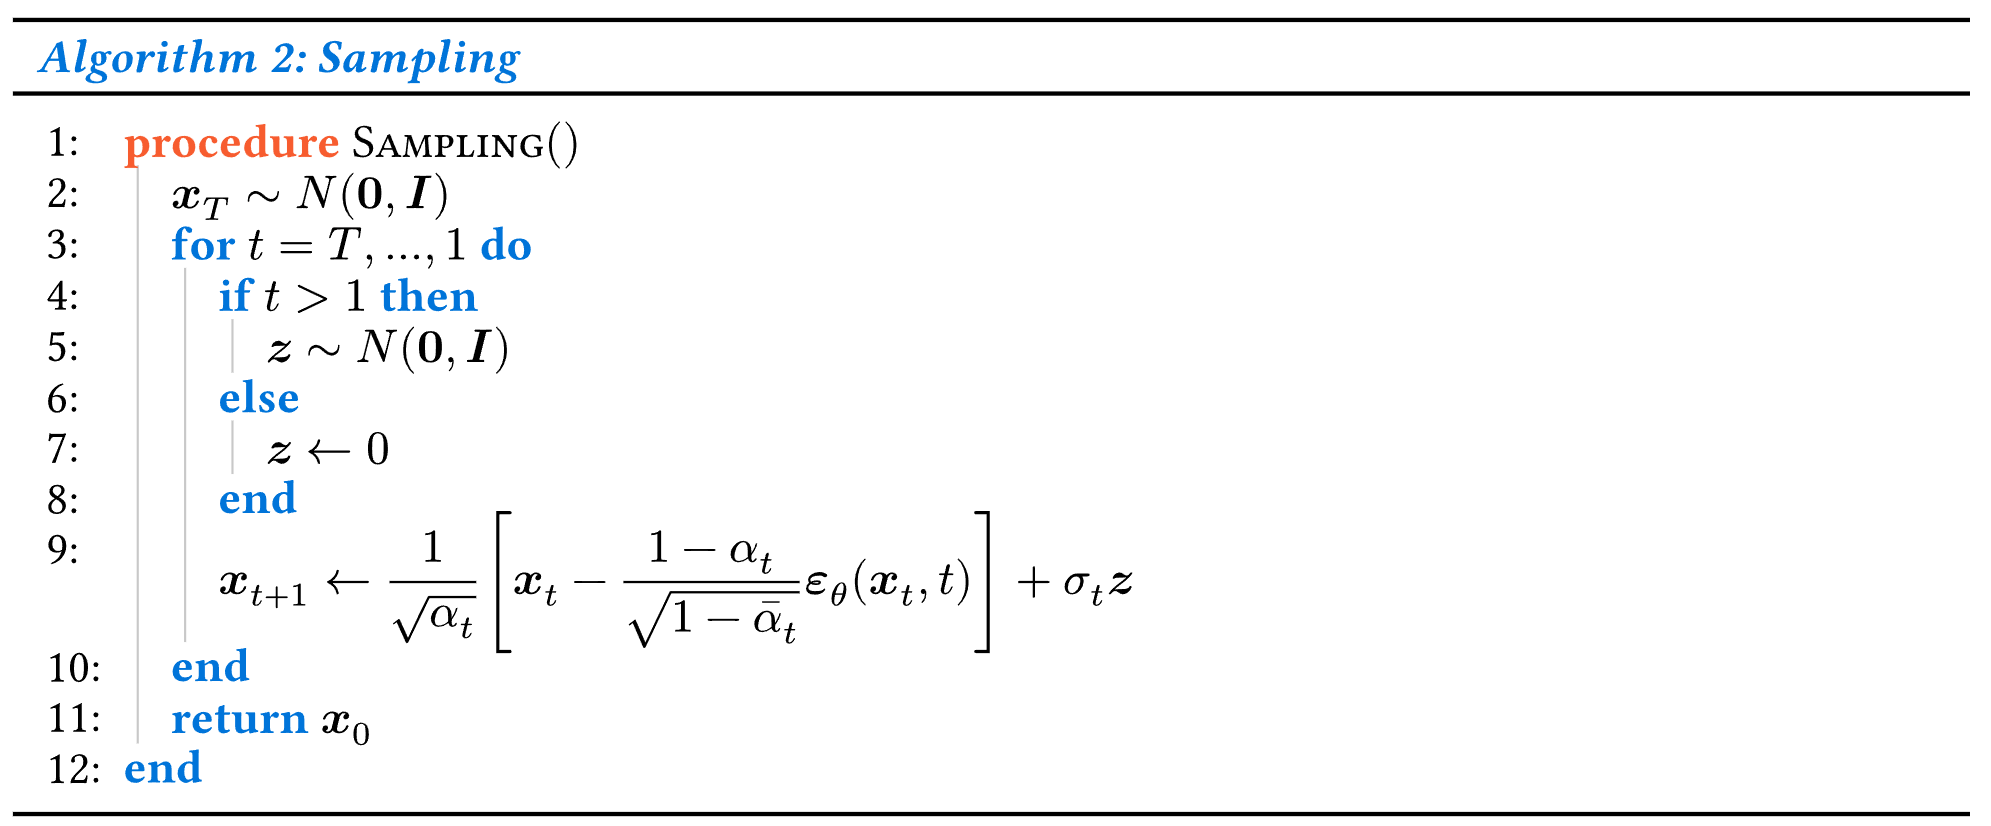
推了半天之后我们发现我们的优化目标也只是预测噪声而已(而这并不是新鲜事),我们就可以很顺利地得到 DDPM 的训练和采样算法。我们也可以使用更加简单的目标函数,只需要将 Lt−1 前面的系数扔掉,同时考虑服从离散均匀分布的 t 即可。在下面的算法中,我们实际上也是随机从均匀分布中采样 t 然后训练模型。

3 训练和采样算法

可以将其与下面的模拟退火 Langevin 动力学采样进行对比
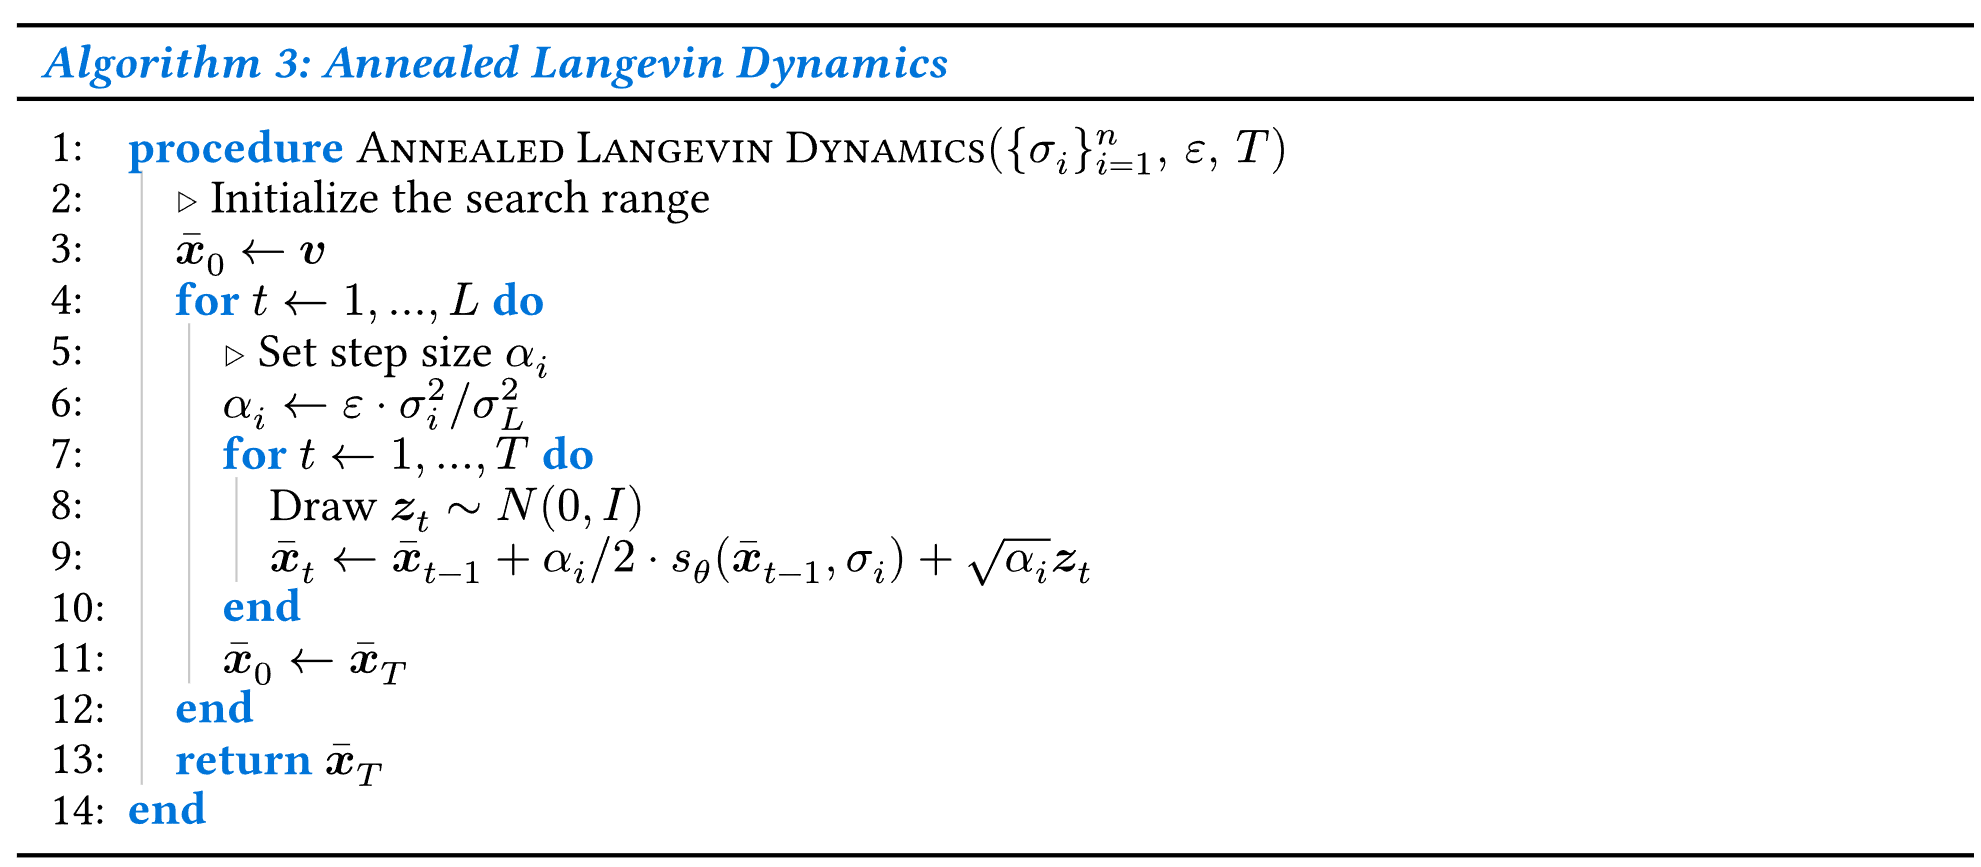
不难发现 DDPM 中的 Sampling 算法将 Annealed Langevin Dynamics 算法中的内层的循环减少到了 1 。

4 离散值图像生成的最后一步

由于需要生成的对象是计算机中离散编码(如八位)的图像,对应最后一步的 pθ(x0|x1) 需要得到的是离散分布。论文使用了一个简便的技巧,假设图像的像素值在离散化过程中从 {0,1,...,255} 线性地归一化到 [−1,1] 内,即 0 被映射到 −1 , 255 被映射到 1 。在计算 x0 的第 i 个像素值是 x0(i) 时,我们可以简单地将 R 切分成 256 块,其中 1∼254 分别对应着 [−1−1/255,1+1/255] 中宽度为 2/255 的小区间 [δ−(x),δ+(x)] ,剩下的一头一尾就分别对应剩下的两个无限长度的区间。具体而言,

δ+(x)={∞if x=1x+1/255if x<1,δ−(x)={−∞if x=−1x−1/255if x>−1

假设 x0 的分布中各分量相互独立,就有

pθ(x0)=∏i=1npθ(x0(i))=∏i=1n∫δ−(x0(i))δ+(x0(i))N(x|μθ(i)(x1,1),σ1I)dx

这样也不会破坏分布的归一化性质。

5 实验

5.1 预测目标和目标函数匹配程度

实验发现,预测 μ~ 需要匹配未化简形式的加权期望损失;而预测噪声 ϵ 需要匹配简化的损失函数。这两个搭配效果几乎一样好。

5.2 去噪过程的协方差矩阵

如果将去噪过程的协方差矩阵变成科学系的对角形式,训练过程会变得不稳定,采样得到的图像质量也会下降。

6 DDPM 的信息论视角

6.1 编码效率和失真度

模型在 CIFAR 上训练得到的对应于每一数据维度的信息比特数相差 0.03 ,这说明模型没有在训练集上过拟合。此外,再回到目标函数,已知有这样的分解:

Eq[DKL[q(xT|x0)∥p(xT)]⏟LT+∑t=2TDKL[q(xt−1|xt,x0)∥pt(xt−1|xt)]⏟Lt−1+−log⁡pt(x0|x1)⏟L0]

注意 L1+⋯+LT−1 中的每一项都是 KL 散度,分别描述神经网络参数化的 pθ 和分布 q 的区别,它是使用 pθ 描述 q 需要的额外编码开销(见附录),因此可将其看做生成过程中的编码效率 (rate),这体现在相对于该体系中认为的最优逆向过程 q 而言所需的额外编码量;而最后一项 L0 是一个负对数似然,它将 x1 和 x0 对齐比较,我们可将其看做从 xT 经过降噪过程一路走来的结果相比于 x0 的失真度 (distortion)。

6.2 分步有损压缩的信道模型

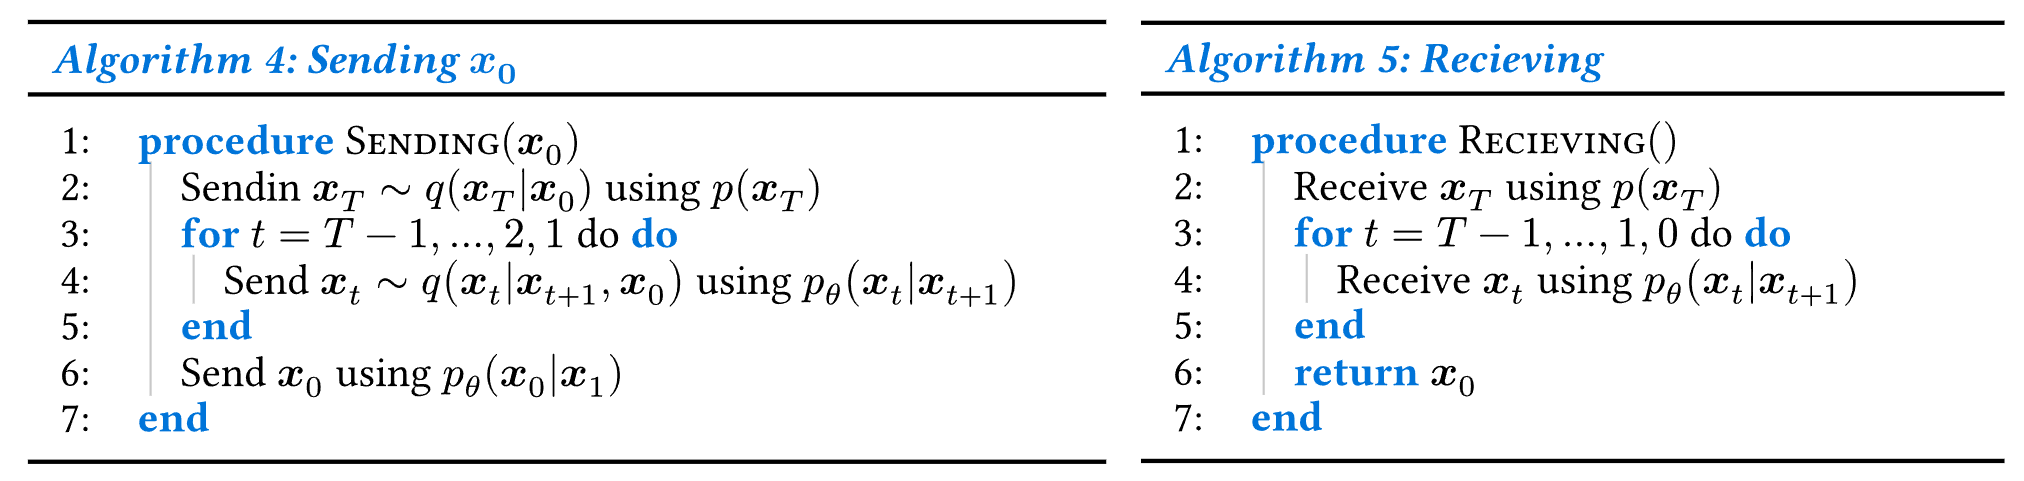
我们可以将 DDPM 的去噪过程看作是发送端向接受端发送信息。接收端在接收前只知道 p ,发送端可以同步逐步使用 pθ(xt|xt+1) 编码服从分布 q(xt|xt+1,x0) 的数据 xt ,然后接收端用 pθ 对其进行解码。如果发送端仅发送 xT ,接收端仅依靠此信息和 pθ 估计 x^0 ,这样会产生较高的失真度。

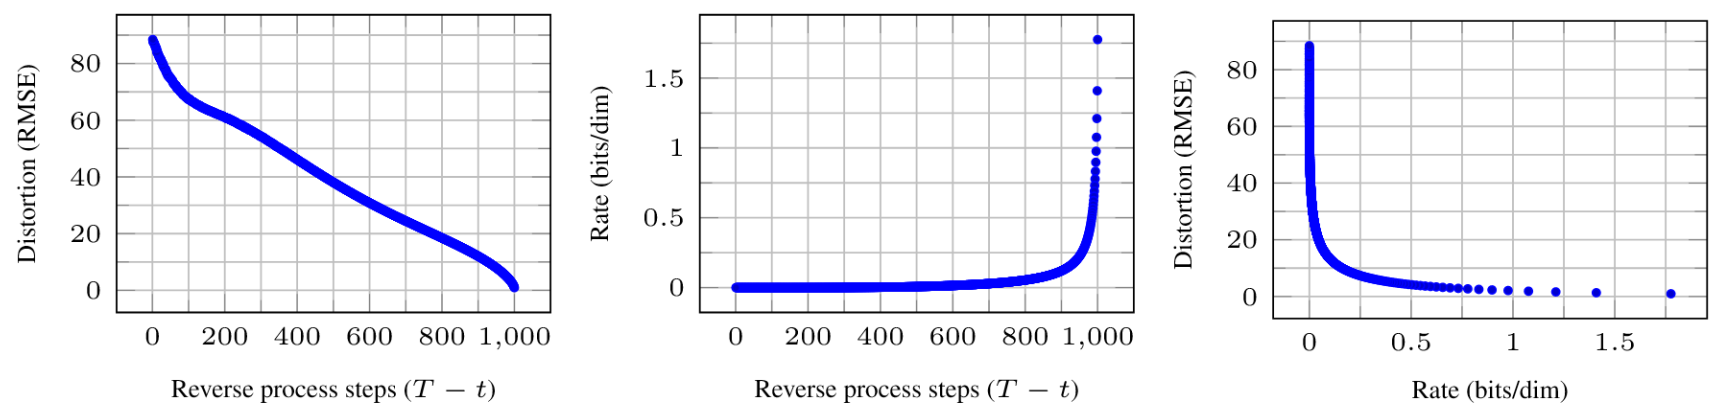
每个时刻 t ,接收端都会计算估计得到的 x^0 和真实值的均方损失作为失真率,而记录自传输开始至该时刻接收器获得的所有每维度比特数为码率:即 H(xt)+DKL[q(xt−1|xt,x0)∥pt(xt−1|xt)] ,画出的码率-失真率曲线可以看出,大量的信息被分配至肉眼难以看见的细节中:

6.3 分步生成

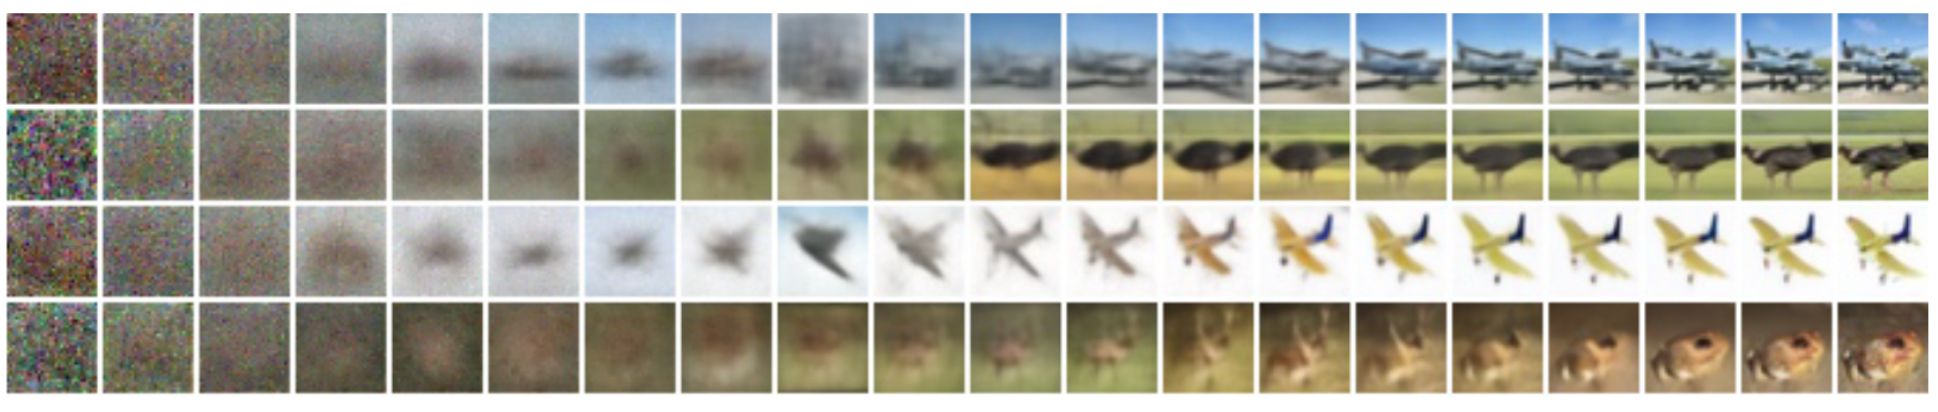
作者还用各部得到的 xt 直接预测 x0 ,得到的结果由下图所示。可见随着 t 的减小,预测得到的 x^0 逐步先显现总体特征,再逐步丰富局部细节。

image

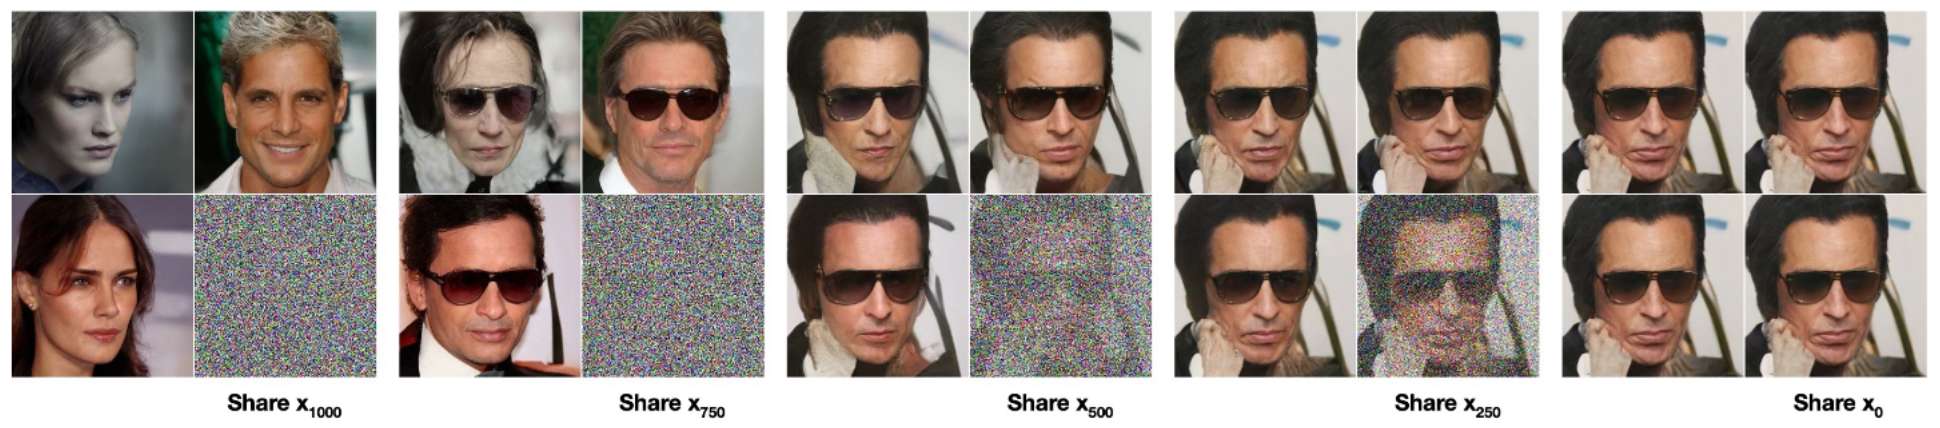
如果使模型都从某个共用的 xt 出发执行降噪过程,越大的 t 出发降噪得到的结果差异越大;越小的 t 出发得到的降噪结果越相似。

image

7 DDPM 和自回归生成模型的比较

最后讨论 DDPM 的降噪过程和序贯生成的自回归生成模型(例如 ChatGPT 的模式)的相似性和区别。我们考虑这样的场景(暂时抛开加噪过程是加 Gauss 过程这件事):生成图像的尺寸是 N×N ,所谓的"加噪过程"和"降噪过程"的步数为 N2 , q(xt|xt−1) 是一个离散的 dirac-delta 点质量,它做的事情是将图像从左至右,从上至下的第 t 个像素变成空白;相应地, q(xt−1) 做的事情就是将第 t 个像素恢复成原来的颜色。这样经过一整条"加噪过程"后,图像就变成了完全空白;再经过理想的"降噪过程"后图像又被逐像素涂色成了原来的样子。

这是我们假设神经网络建模的 pθ ,足够强大——它可以学习到上面假设中 q(xt−1|xt) 的分布,那么这俨然成了自回归模型。然而实践过程中,DDPM 选择的使用 Gauss 噪声加噪、去噪的过程,可以看作是更为广义的自回归生成模型,它按照图像中的某种空间语义 token 按照从整体至局部的顺序逐渐生成图像。相比于添加更强归纳偏置的一般自回归生成模型——它们都假设后生成的区域依赖于先生成的区域,而这在图像生成上没有道理!——DDPM 拥有更高的灵活性和更少的归纳偏置,这也解释了其优异的生成能力。

8 隐空间插值

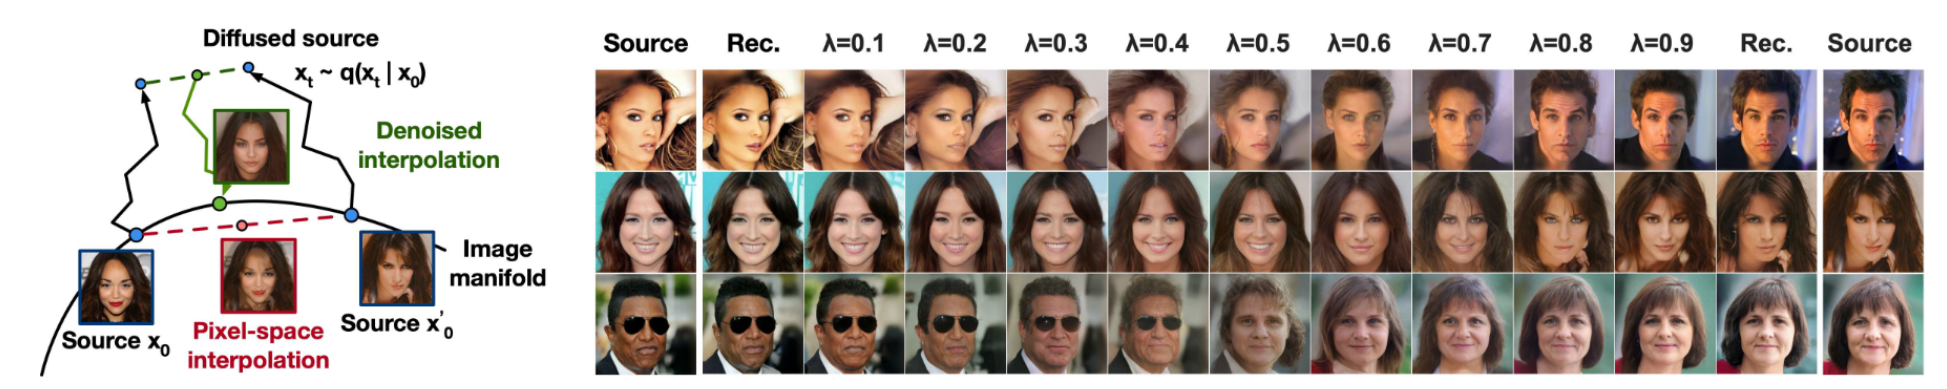
最后,作者将不同图像加噪过程中某个 t (例如 t=500 )得到的 xt 和 x^t 做凸组合,再做去噪过程,得到了原图 x0 和 x^0 之间的顺滑渐变。

image